Топ вопросов по ML
Выберите грейды
Выберите модули
Вопросы
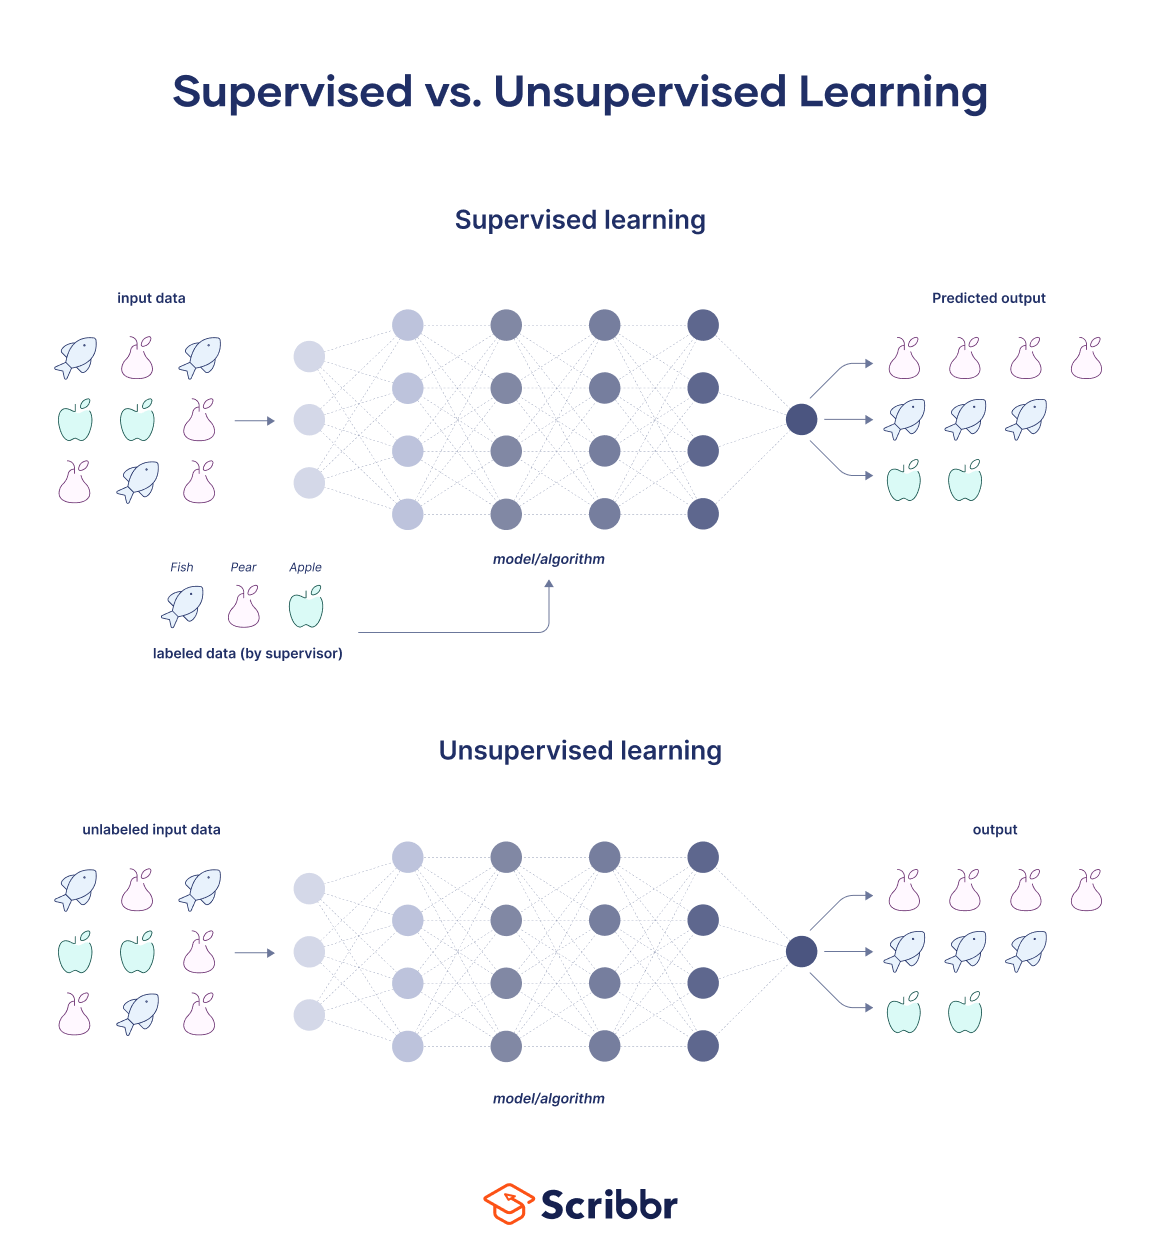
Различия между обучением с учителем и обучением без учителя
В чем отличие между обучением с учителем (supervised learning) и обучением без учителя (unsupervised learning)?
Ответ для собеседования
Обучение с учителем (supervised learning) использует размеченные данные, где для каждого входного примера известен правильный выход.
Цель — научить модель предсказывать этот выход для новых данных.
Обучение без учителя (unsupervised learning) работает с неразмеченными данными.
Цель — найти скрытые закономерности или структуры в данных без предварительно заданных ответов.
Подробный ответ
Обучение с учителем (supervised learning).
В этом подходе модель обучается на наборе данных, который включает как входные признаки, так и соответствующие им целевые переменные (метки). Алгоритм учится сопоставлять входные данные с правильными выходными данными.
Модель получает обратную связь в виде разницы между предсказанным и фактическим значением, что позволяет ей корректировать свои параметры.
Примеры задач:
- классификация (предсказание дискретной метки, например, спам/не спам)
- регрессия (предсказание непрерывного значения, например, цена дома)
Обучение без учителя (unsupervised learning):
В отличие от обучения с учителем, здесь модель работает с неразмеченными данными, то есть без заранее известных целевых переменных.
Цель состоит в том, чтобы обнаружить скрытые структуры, закономерности или взаимосвязи в данных.
Примеры задач:
- кластеризация (группировка схожих точек данных, например, сегментация клиентов)
- снижение размерности (уменьшение количества признаков при сохранении важной информации, например, PCA).
| Тип обучения | Обучение с учителем (Supervised learning) | Обучение без учителя (Unsupervised learning) |
|---|---|---|
| Описание | Модель обучается на размеченных данных — есть входные признаки и известные целевые значения. | Модель обучается на нераспознанных данных, где нет целевых меток. |
| Цель | Научиться сопоставлять вход и выход, минимизируя ошибку между предсказанным и фактическим значением. | Найти скрытые структуры, закономерности и группы в данных. |
| Примеры задач | Классификация (спам / не спам), регрессия (цена дома). | Кластеризация (сегментация клиентов), снижение размерности (PCA). |
Переобучение и недообучение
Что такое переобучение (overfitting) и недообучение (underfitting)? Как их избежать?
Ответ для собеседования
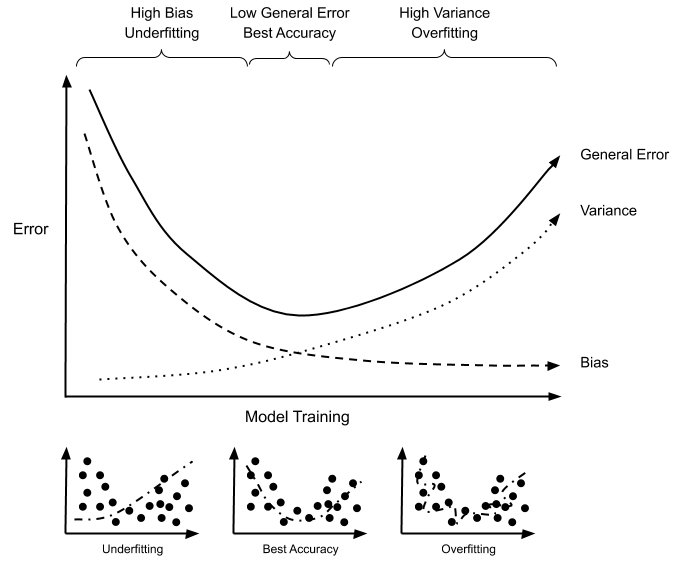
Переобучение (overfitting) происходит, когда модель слишком хорошо запоминает обучающие данные, включая шум, и плохо обобщает новые данные.
Недообучение (underfitting) — это когда модель слишком проста и не улавливает основные закономерности в данных. Избежать переобучения помогают методы регуляризации, кросс-валидация, увеличение объема данных.
Недообучение можно исправить, используя более сложную модель или добавляя больше релевантных признаков.
Подробный ответ
Переобучение (overfitting) - модель становится слишком сложной и начинает
запоминать шум в обучающих данных, что приводит к плохой производительности на новых, невидимых данных. Это происходит, когда модель имеет слишком много параметров или когда обучающие данные слишком малы и нерепрезентативны.
Как избежать:
- Регуляризация: добавление штрафных членов к функции потерь, чтобы уменьшить сложность модели (например, L1, L2 регуляризация).
- Кросс-валидация: использование методов, таких как K-Fold Cross-Validation, для более надежной оценки производительности модели и выявления переобучения.
- Увеличение объема данных (data augmentation): чем больше данных, тем меньше вероятность, что модель запомнит шум.
- Уменьшение сложности модели: использование более простых моделей или уменьшение количества признаков.
- Ранняя остановка (early stopping): прекращение обучения, когда производительность модели на валидационном наборе начинает ухудшаться.
- Выключение случайных нейронов (dropout, нейронные сети) - на каждой итерации обучения случайно "отключаются" некоторые нейроны, что предотвращает избыточное подстраивание под обучающие данные.
Недообучение (underfitting) - модель слишком проста и не может уловить основные закономерности в обучающих данных, что приводит к низкой производительности как на обучающих, так и на тестовых данных. Это может произойти, если модель имеет слишком мало параметров или если важные признаки отсутствуют.
Как избежать:
- Увеличение сложности модели - использование более сложных моделей (например, добавление слоев в нейронную сеть).
- Добавление релевантных признаков - включение в модель большего количества признаков, которые могут помочь ей уловить закономерности.
- Уменьшение регуляризации - снижение силы регуляризации, чтобы модель могла лучше подстраиваться под данные.
Заголовок вопроса
Случайное содержание вопроса
Разница между классификацией и регрессией
В чем разница между классификацией и регрессией?
Ответ для собеседования
Классификация — задача предсказания дискретной метки класса (например, да/нет).
Регрессия — задача предсказания непрерывного значения (например, цена дома).
Подробный ответ
Классификация это задача, в которой модель предсказывает принадлежность объекта к одному из заранее определенных классов. Выходные данные являются дискретными. Например, классификация электронных писем на «спам» и «не спам», определение типа опухоли (злокачественная/доброкачественная) или распознавание рукописных цифр.
Алгоритмы, используемые для классификации:
- метод опорных векторов (SVM)
- деревья решений
- нейронные сети
Регрессия это задача, в которой модель предсказывает непрерывное числовое значение. Выходные данные являются непрерывными. Например, предсказание цены дома на основе его характеристик, прогнозирование температуры на завтра или оценка спроса на продукт.
Алгоритмы, используемые для регрессии:
- включают линейную регрессию
- полиномиальную регрессию
- деревья решений
- нейронные сети
| Тип задачи | Классификация | Регрессия |
|---|---|---|
| Описание | Модель предсказывает, к какому классу принадлежит объект. | Модель предсказывает непрерывное числовое значение. |
| Выходные данные | Дискретные значения (метки классов). | Непрерывные значения (числа). |
| Примеры задач | Спам / не спам, тип опухоли, распознавание рукописных цифр. | Цена дома, прогноз температуры, оценка спроса на продукт. |
| Примеры алгоритмов | Метод опорных векторов (SVM), деревья решений, нейронные сети. | Линейная регрессия, полиномиальная регрессия, деревья решений, нейронные сети. |
Метод k-ближайших соседей
Что такое метод k-ближайших соседей (KNN)?
Ответ для собеседования
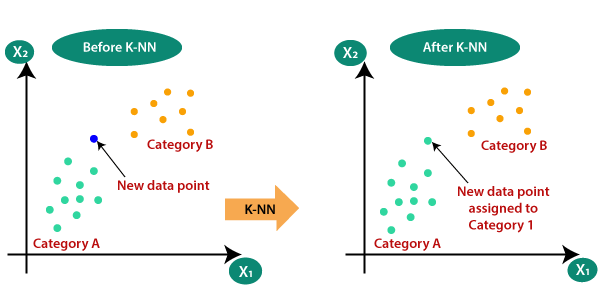
Метод k-ближайших соседей (KNN) — это простой алгоритм, который классифицирует новую точку данных на основе большинства голосов ее k ближайших соседей в обучающей выборке. Он не требует обучения модели в явном виде и является примером ленивого обучения.
Подробный ответ
Метод k-ближайших соседей (k-Nearest Neighbors, KNN) — это непараметрический алгоритм, используемый для классификации и регрессии. Его основная идея заключается в том, что похожие объекты находятся близко друг к другу. Для классификации новой точки данных алгоритм находит k ближайших к ней точек из обучающей выборки (соседей) и присваивает новой точке тот класс, который является наиболее распространенным среди ее соседей.
Для регрессии предсказанное значение является средним или медианным значением целевой переменной у k ближайших соседей. Расстояние между точками обычно измеряется с помощью евклидовой метрики, но могут использоваться и другие метрики.
Выбор значения k является важным гиперпараметром:
- маленькое k делает модель чувствительной к шуму
- большое k может привести к размыванию границ между классами
Деревья решений (Decision Trees)
Что такое деревья решений (decision trees)?
Ответ для собеседования
Дерево решений — это модель, которая представляет собой древовидную структуру, где каждый внутренний узел представляет собой проверку атрибута, каждая ветвь — результат проверки, а каждый листовой узел — метку класса.
Они интуитивно понятны и легко интерпретируемы.
Подробный ответ
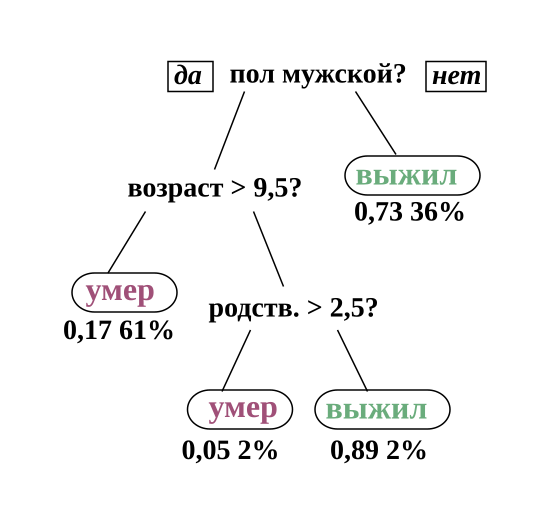
Дерево решений (decision tree) — это непараметрический алгоритм машинного обучения, который может использоваться как для классификации, так и для регрессии. Модель строится в виде древовидной структуры, где каждый внутренний узел представляет собой «тест» на определенном признаке (например, возраст > 30), каждая ветвь представляет результат теста, а каждый листовой узел (терминальный узел) представляет собой решение (метку класса или непрерывное значение).
Путь от корня до листа представляет собой правило классификации. Деревья решений строятся путем рекурсивного разделения данных на подмножества на основе признаков, которые наилучшим образом разделяют данные. Критерии разделения, такие как прирост информации (Information Gain) или индекс Джини (Gini Impurity), используются для выбора наилучшего признака на каждом шаге.
Деревья решений склонны к переобучению, но эту проблему можно решить с помощью методов обрезки (pruning) или использования ансамблевых методов, таких как случайный лес.
Пример с датасетом Титаника:
Заголовок вопроса
Случайное содержание вопроса
Обрабатка пропущенные значений в данных
Как вы обрабатываете пропущенные значения в данных?
Ответ для собеседования
Существует несколько подходов:
- удаление строк или столбцов с пропущенными значениями, если их немного
- замена пропущенных значений средним, медианой или модой
- использование более сложных методов, таких как регрессионное заполнение или алгоритмы, которые могут работать с пропущенными данными напрямую
Подробный ответ
Удаление строк (Listwise deletion) — удаление всех наблюдений с хотя бы одним пропущенным значением. Это может привести к потере большого количества данных.
Удаление столбцов (Pairwise deletion) — удаление признаков с большим количеством пропущенных значений.
Заполнение (Imputation):
- Простое заполнение — замена пропущенных значений средним (для числовых данных), медианой (для числовых данных с выбросами) или модой (для категориальных данных).
- Заполнение на основе модели — использование других признаков для предсказания пропущенных значений с помощью моделей машинного обучения (например, линейной регрессии или k-NN).
- Использование алгоритмов, устойчивых к пропущенным значениям: Некоторые алгоритмы, такие как XGBoost, имеют встроенные методы работы с такими значениями.
Выбор метода зависит от количества пропущенных данных, их распределения и типа данных.
Что такое глубокое обучение (Deep Learning)
Что такое глубокое обучение (Deep Learning)?
Ответ для собеседования
Глубокое обучение (Deep Learning) — это подраздел машинного обучения, основанный на искусственных нейронных сетях с множеством слоев (глубоких нейронных сетях). Оно особенно эффективно для задач с большими объемами данных, таких как распознавание изображений и обработка естественного языка.
Подробный ответ
Глубокое обучение (Deep Learning, DL) — это класс методов машинного обучения, основанных на искусственных нейронных сетях. «Глубина» относится к наличию нескольких скрытых слоев в нейронной сети, что позволяет модели изучать иерархические представления данных.
Начиная с простых признаков на нижних слоях, сеть может строить все более сложные и абстрактные представления на верхних слоях. Это делает глубокое обучение особенно мощным для задач с неструктурированными данными:
- изображения
- звук
- текст
Основные архитектуры глубокого обучения включают сверточные нейронные сети (CNN) для компьютерного зрения и рекуррентные нейронные сети (RNN) для последовательных данных, а также трансформеры, которые стали стандартом в NLP.
Заголовок вопроса
Случайное содержание вопроса
Заголовок вопроса
Случайное содержание вопроса
Выбросы и как с ними бороться
Что такое выбросы (outliers) и как с ними бороться?
Ответ для собеседования
Выбросы (outliers) — это точки данных, которые значительно отличаются от других наблюдений. Их можно обнаружить с помощью визуализации (ящичковые диаграммы) или статистических методов (z-оценка, межквартильный размах).
Бороться с ними можно путем удаления, замены (например, на медиану) или использования моделей, устойчивых к выбросам.
Подробный ответ
Основные способы обнаружение выбросов:
Визуализация: ящичковые диаграммы (box plots), диаграммы рассеяния (scatter plots).
Статистические методы:
- Z-оценка: Точки с z-оценкой
> 3или< -3считаются выбросами.
- Межквартильный размах (IQR): Точки, выходящие за пределы
[Q1 - 1.5*IQR, Q3 + 1.5*IQR], считаются выбросами.
Алгоритмы обнаружения аномалий:
- Isolation Forest: Алгоритм машинного обучения без учителя (unsupervised) для обнаружения аномалий, который выделяет аномальные точки данных, изолируя их с помощью случайных разбиений в ансамбле деревьев решений. Его ключевая идея в том, что аномалии легче изолировать от нормальных данных, чем сами нормальные точки, требуя для этого меньшего количества шагов (глубины дерева).
- Local Outlier Factor (LOF): Алгоритм машинного обучения без учителя, который выявляет аномалии (выбросы) в данных, сравнивая локальную плотность точки с плотностями ее соседей, а не с плотностью всего набора данных. Точки, которые имеют значительно меньшую плотность, чем их соседи, считаются выбросам.
Заголовок вопроса
Случайное содержание вопроса
Заголовок вопроса
Случайное содержание вопроса
Заголовок вопроса
Случайное содержание вопроса
Разница между MLE и MAP
В чем разница между MLE и MAP и когда используется каждый из них?
Ответ для собеседования
MLE (Maximum Likelihood Estimation) ищет параметры θ, которые максимизируют правдоподобие данных P(D∣θ).
MAP (Maximum A Posteriori) ищет параметры, которые максимизируют апостериорную вероятность P(θ∣D), используя априорное распределение P(θ). MAP — это Байесовский подход, который включает регуляризацию.
Подробный ответ
MLE предполагает, что все параметры θ одинаково вероятны (равномерное априорное распределение), и фокусируется только на данных.
MAP включает априорное распределение P(θ), которое отражает наше предварительное знание о параметрах.
MAP основывается на Теореме Байеса:
MAP включает априорное распределение P(θ), которое отражает наше предварительное знание о параметрах. Связь с регуляризацией:
- Если мы выберем Гауссово (нормальное) априорное распределение для весов P(θ), то максимизация MAP эквивалентна минимизации функции потерь с L2-регуляризацией (Ridge).
- Если мы выберем Распределение Лапласа для весов P(θ), то максимизация MAP эквивалентна минимизации функции потерь с L1-регуляризацией (Lasso). MAP используется, когда нужно ввести регуляризацию или когда данных мало, и априорное знание может стабилизировать оценку параметров.
Задача на обучение с учителем
Какая из следующих задач является примером обучения с учителем?
Ответ для собеседования
Предсказание цены акции является задачей регрессии, где модель обучается на исторических данных (размеченные данные) для предсказания будущего значения.
Остальные варианты являются примерами обучения без учителя (кластеризация и обнаружение аномалий)
Подробный ответ
Предсказание цены акции — это задача регрессии, то есть обучения с учителем.
Модель получает на вход размеченные исторические данные — например, цену акций, объём торгов, макроэкономические индикаторы — и обучается предсказывать числовое значение (будущую цену).
В отличие от этого, кластеризация и обнаружение аномалий относятся к обучению без учителя, где модель не имеет целевой переменной и самостоятельно ищет скрытые закономерности или выбросы в данных.
Заголовок вопроса
Случайное содержание вопроса
Нормальное распределение в ML
Что такое нормальное распределение и почему оно часто используется в машинном обучении?
Ответ для собеседования
Нормальное (Гауссово) распределение — это симметричное распределение в форме колокола, полностью описываемое средним значением (μ) и стандартным отклонением (σ). Оно важно, потому что многие природные явления и, главное, ошибки предсказания в моделях часто распределены нормально (согласно Центральной Предельной Теореме).
Подробный ответ
Нормальное распределение N(μ,σ2) является краеугольным камнем в статистике и машинном обучении по нескольким причинам:
- Центральная Предельная Теорема (ЦПТ): Сумма большого числа независимых случайных величин, независимо от их собственного распределения, стремится к нормальному распределению. Это дает теоретическое обоснование для предположения о нормальности ошибок.
- Линейная регрессия: Классическая линейная регрессия предполагает, что остатки (ошибки) имеют нормальное распределение. Это предположение позволяет использовать метод Наименьших Квадратов (OLS) и обеспечивает статистическую значимость оценок.
- Инициализация весов: Веса нейронных сетей часто инициализируются случайными значениями из нормального распределения.
Задача на деревья решений
Какой алгоритм строит множество деревьев решений на случайных подвыборках данных и усредняет их предсказания?
Ответ для собеседования
Случайный лес (Random Forest) является ансамблевым методом, который использует бэггинг для создания множества деревьев решений и усреднения их результатов для повышения точности и уменьшения переобучения.
Подробный ответ
Случайный лес (Random Forest) — это ансамблевый метод, основанный на бэггинге (bootstrap aggregating).
Он строит множество независимых деревьев решений на случайных подвыборках данных и признаков, а затем усредняет их предсказания (для регрессии) или использует голосование (для классификации).
Такой подход повышает устойчивость и точность модели, снижает переобучение и уменьшает дисперсию по сравнению с отдельным деревом решений.
Затухание градиентов
В чем заключается проблема "затухания градиентов" (Vanishing Gradient) и как ее решают?
Ответ для собеседования
Затухание градиентов — это проблема, при которой градиенты становятся очень маленькими по мере распространения назад через глубокие слои, что приводит к остановке обучения ранних слоев. Это было вызвано использованием сигмоидных активационных функций.
Решается с помощью ReLU, Batch Normalization и архитектур, таких как ResNet.
Подробный ответ
Проблема возникает из-за правила цепи. Если мы используем сигмоидную активационную функцию σ(z), ее производная σ′(z) лежит в диапазоне (0,0.25]. При умножении этих малых чисел на каждом слое (в Backpropagation), градиент ∂L/∂W для ранних слоев становится экспоненциально малым, что делает их обновления незначительными.
Пути решения:
- ReLU (Rectified Linear Unit): Производная ReLU равна 1 для положительных значений, что предотвращает затухание.
- Архитектуры: LSTM/GRU (для рекуррентных сетей) и ResNet (Residual Networks) используют "skip connections", которые позволяют градиенту обходить слои и напрямую передаваться в ранние слои.
- Batch Normalization: Нормализует активации внутри мини-батча, что стабилизирует распределение входных данных для каждого слоя и позволяет использовать более высокие скорости обучения.
Регуляризация (Regularization)
Что такое регуляризация (Regularization)?
Ответ для собеседования
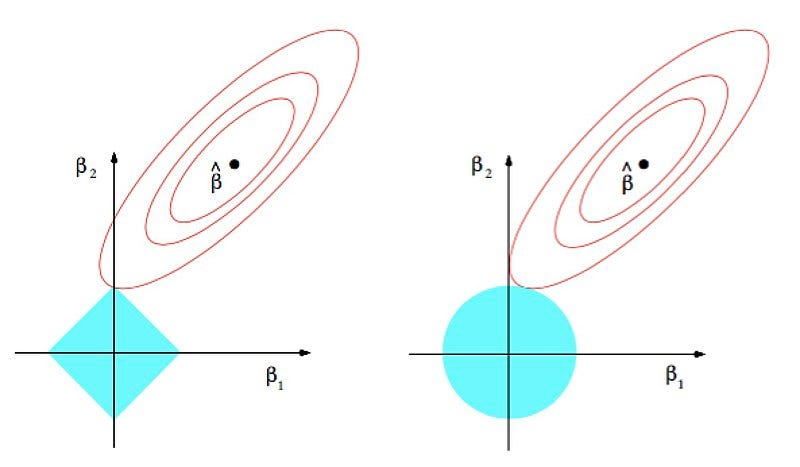
Регуляризация (regularization) — это техника, используемая для предотвращения переобучения путем добавления штрафа к функции потерь модели. Этот штраф наказывает большие значения весов, делая модель более простой и улучшая ее обобщающую способность.
Подробный ответ
Регуляризация (regularization) — это набор методов, направленных на уменьшение сложности модели и предотвращение переобучения. Она достигается путем добавления дополнительного члена (штрафа) к функции потерь, который зависит от весов модели.
Наиболее распространенные типы регуляризации:
- L1-регуляризация (Lasso): Добавляет штраф, равный сумме абсолютных значений весов. Она может приводить к обнулению некоторых весов, что эффективно выполняет отбор признаков.
- L2-регуляризация (Ridge): Добавляет штраф, равный сумме квадратов весов. Она уменьшает большие веса, но не обнуляет их.
- Elastic Net: Комбинация L1 и L2 регуляризации, которая сочетает в себе преимущества обоих методов.
Метод опорных векторов (SVM)
Что такое метод опорных векторов (SVM)?
Ответ для собеседования
Метод опорных векторов (SVM) — это алгоритм классификации, который находит оптимальную гиперплоскость, разделяющую классы в пространстве признаков с максимальным зазором. Это делает модель более устойчивой к новым данным.
Подробный ответ
Метод опорных векторов (Support Vector Machine, SVM) — мощный алгоритм машинного обучения, используемый для задач классификации и регрессии. Основная идея SVM заключается в построении гиперплоскости (или набора гиперплоскостей) в многомерном пространстве, которая наилучшим образом разделяет точки данных разных классов.
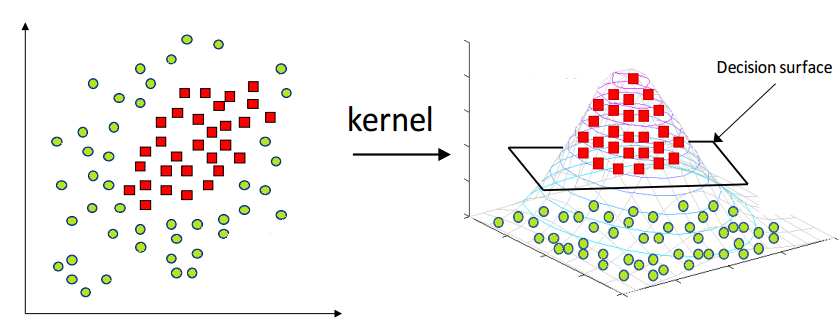
Оптимальная гиперплоскость — это та, которая имеет максимальный зазор (margin) между ближайшими точками каждого класса, называемыми опорными векторами. SVM может эффективно выполнять нелинейную классификацию с помощью так называемого «ядерного трюка» (kernel trick), который неявно отображает входные данные в более высокоразмерное пространство, где они становятся линейно разделимыми.
Популярные ядра включают:
- линейное
- полиномиальное
- радиальную базисную функцию (RBF)
- сигмоидальное
Заголовок вопроса
Случайное содержание вопроса
PCA и SVD
Объясните математическую связь между PCA и SVD и почему SVD предпочтительнее?
Ответ для собеседования
PCA основан на разложении ковариационной матрицы на собственные числа и векторы. SVD разлагает саму матрицу данных X на UΣVT. SVD предпочтительнее, потому что он численно более стабилен, работает с неквадратными матрицами и позволяет избежать явного вычисления большой ковариационной матрицы.
Подробный ответ
PCA и SVD тесно связаны. Если X — центрированная матрица данных, то ковариационная матрица:
PCA находит собственные векторы и числа матрицы C.
SVD разлагает X = UΣVT.
Связь — правые сингулярные векторы V из SVD являются собственными векторами ковариационной матрицы C. Сингулярные числа σi связаны с собственными числами λi как 𝜎i2 = (n−1)λi
К реимуществам SVD относится численная стабильность:
- Вычисление XTX может привести к потере точности из-за округления, особенно при работе с большими числами. SVD работает напрямую с X.
- Универсальность: SVD применим к любой матрице, тогда как PCA (через собственные векторы) требует симметричной ковариационной матрицы.
В библиотеках, таких как scikit-learn, PCA реализуется через SVD.
ROC-кривая и AUC
Что такое ROC-кривая и AUC?
Ответ для собеседования
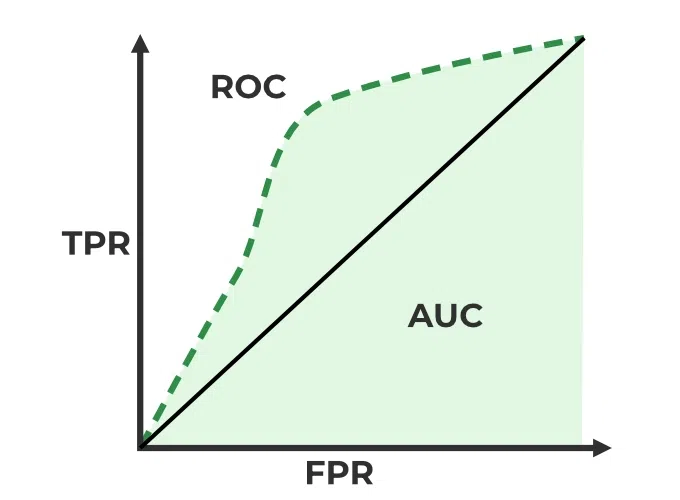
ROC-кривая (Receiver Operating Characteristic) — это график, который показывает производительность модели бинарной классификации при различных порогах классификации. Он строит зависимость доли истинно положительных результатов (TPR) от доли ложноположительных результатов (FPR).
AUC (Area Under the Curve) — это площадь под ROC-кривой, которая служит единой метрикой качества модели: чем ближе AUC к 1, тем лучше модель.
Подробный ответ
ROC-кривая — это график, который иллюстрирует диагностическую способность бинарного классификатора при изменении порога дискриминации. По оси Y откладывается доля истинно положительных результатов (True Positive Rate, TPR), также известная как чувствительность (Recall), а по оси X — доля ложноположительных результатов (False Positive Rate, FPR). Идеальная модель имела бы ROC-кривую, которая проходит через верхний левый угол (TPR=1, FPR=0).
AUC (площадь под кривой) — это числовая метрика, которая измеряет общую производительность модели классификации. AUC представляет собой вероятность того, что случайно выбранный положительный пример будет оценен моделью выше, чем случайно выбранный отрицательный пример.
AUC=0.5соответствует случайному угадываниюAUC=1.0— идеальной модели.
Рекуррентные нейронные сети (RNN)
Что такое рекуррентные нейронные сети (RNN)?
Ответ для собеседования
Рекуррентные нейронные сети (RNN) — это тип нейронных сетей, предназначенный для работы с последовательными данными, такими как временные ряды или текст. Они имеют внутреннюю память, которая позволяет им обрабатывать информацию из предыдущих шагов последовательности.
Подробный ответ
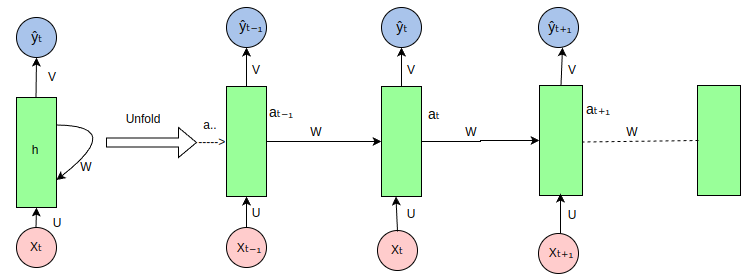
Рекуррентные нейронные сети (Recurrent Neural Networks, RNN) — это класс нейронных сетей, в которых соединения между узлами образуют направленный граф вдоль временной последовательности. Это позволяет им использовать внутреннее состояние (память) для обработки последовательностей переменной длины.
В отличие от сетей прямого распространения, RNN могут использовать свою внутреннюю память для обработки произвольных последовательностей входов. Однако стандартные RNN страдают от проблемы затухающего и взрывающегося градиента, что затрудняет обучение на длинных последовательностях. Для решения этой проблемы были разработаны более сложные архитектуры, такие как LSTM (Long Short-Term Memory) и GRU (Gated Recurrent Unit), которые используют механизмы шлюзов для управления потоком информации.
Сверточные нейронные сети (CNN)
Что такое сверточные нейронные сети (CNN)?
Ответ для собеседования
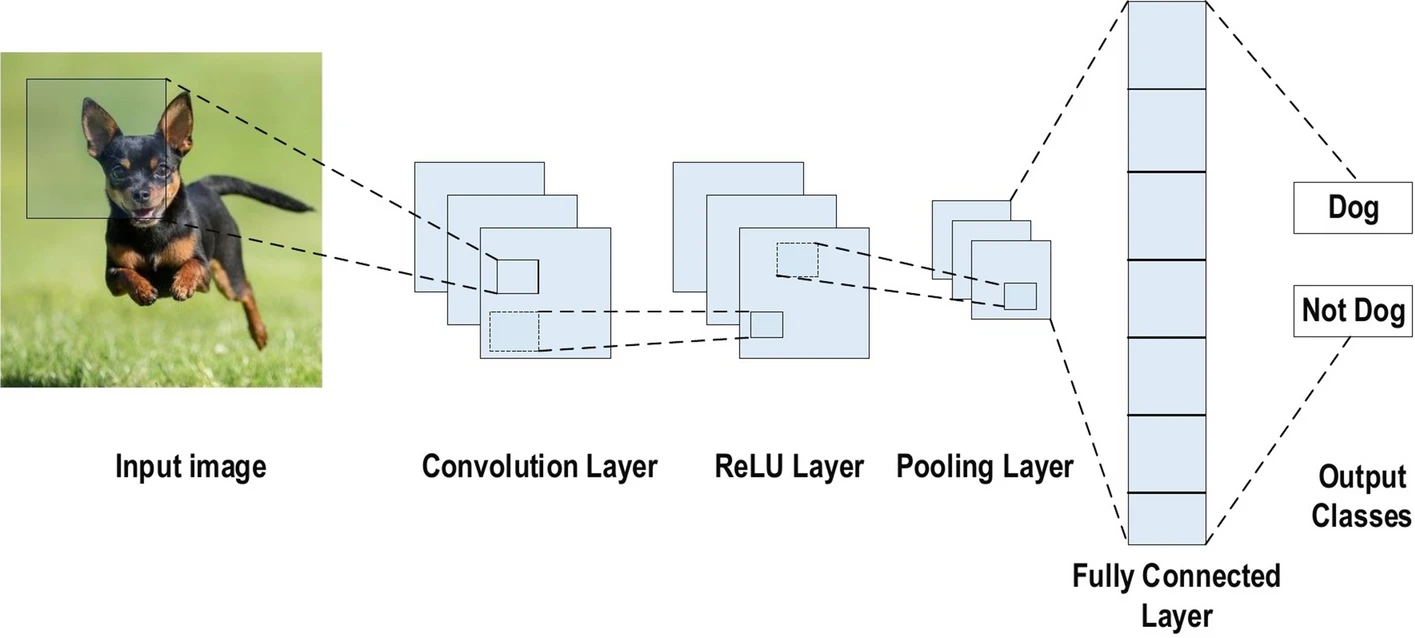
Сверточные нейронные сети (CNN) — это тип глубоких нейронных сетей, специально разработанный для обработки данных с сеточной структурой, таких как изображения. Они используют сверточные слои для автоматического и адаптивного изучения пространственных иерархий признаков
Подробный ответ
Сверточные нейронные сети (Convolutional Neural Networks, CNN) — это класс глубоких нейронных сетей, которые особенно хорошо подходят для анализа визуальных данных.
Ключевые компоненты CNN:
- Сверточный слой (Convolutional Layer): Применяет набор обучаемых фильтров (ядер) к входному изображению, создавая карты признаков. Это позволяет сети обнаруживать локальные паттерны, такие как края, углы и текстуры.
- Слой подвыборки (Pooling Layer): Уменьшает пространственный размер карт признаков, что снижает вычислительную нагрузку и помогает сделать представление более инвариантным к небольшим сдвигам и искажениям.
- Полносвязный слой (Fully Connected Layer): Используется в конце сети для выполнения задачи классификации или регрессии на основе извлеченных признаков.
CNN произвели революцию в компьютерном зрении и используются в таких задачах, как:
- распознавание объектов
- сегментация изображений
- анализ медицинских изображений
Заголовок вопроса
Случайное содержание вопроса

